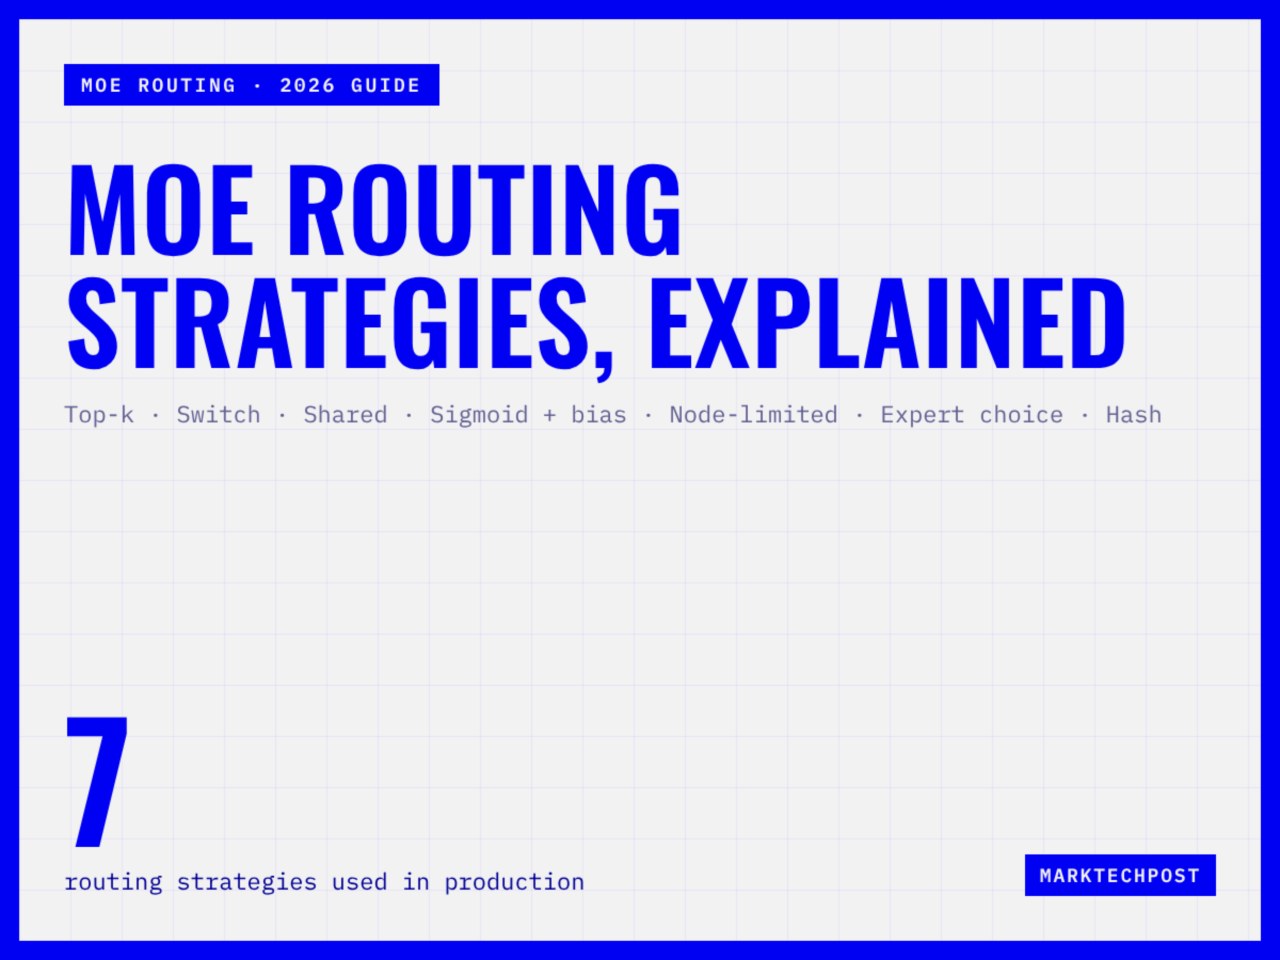
Механизм маршрутизации MoE направляет токены к ограниченному числу экспертных сетей. Например, модель Mixtral 8x7B задействует 13 млрд активных параметров из 47 млрд. В модели gpt-oss-120b выбираются 4 эксперта из 128, а в Qwen3-235B-A22B — 8 из 128.
Архитектура DeepSeek-V3 сочетает общие и специализированные эксперты, активируя 8 из 256 маршрутизируемых экспертов. В этой модели применяется сигмоидальное взвешивание с балансировкой смещения. DeepSeek-V4 использует функцию sqrtsoftplus и хэш-маршрутизацию в первых трех слоях MoE.
Метод expert-choice от Google позволяет экспертам выбирать токены, что ускоряет сходимость обучения более чем в 2 раза. Однако это вызывает причинно-следственную утечку, так как выбор эксперта зависит от будущих токенов. Исследователи зафиксировали аномальное падение потерь на 10%.
Динамический top-k позволяет варьировать количество активных экспертов для каждого токена. Внедрение этого метода в SGLang улучшило показатель P99 времени до первого токена в 1,21–1,26 раза. Настройки маршрутизации задаются в файле config.json перед запуском модели.