

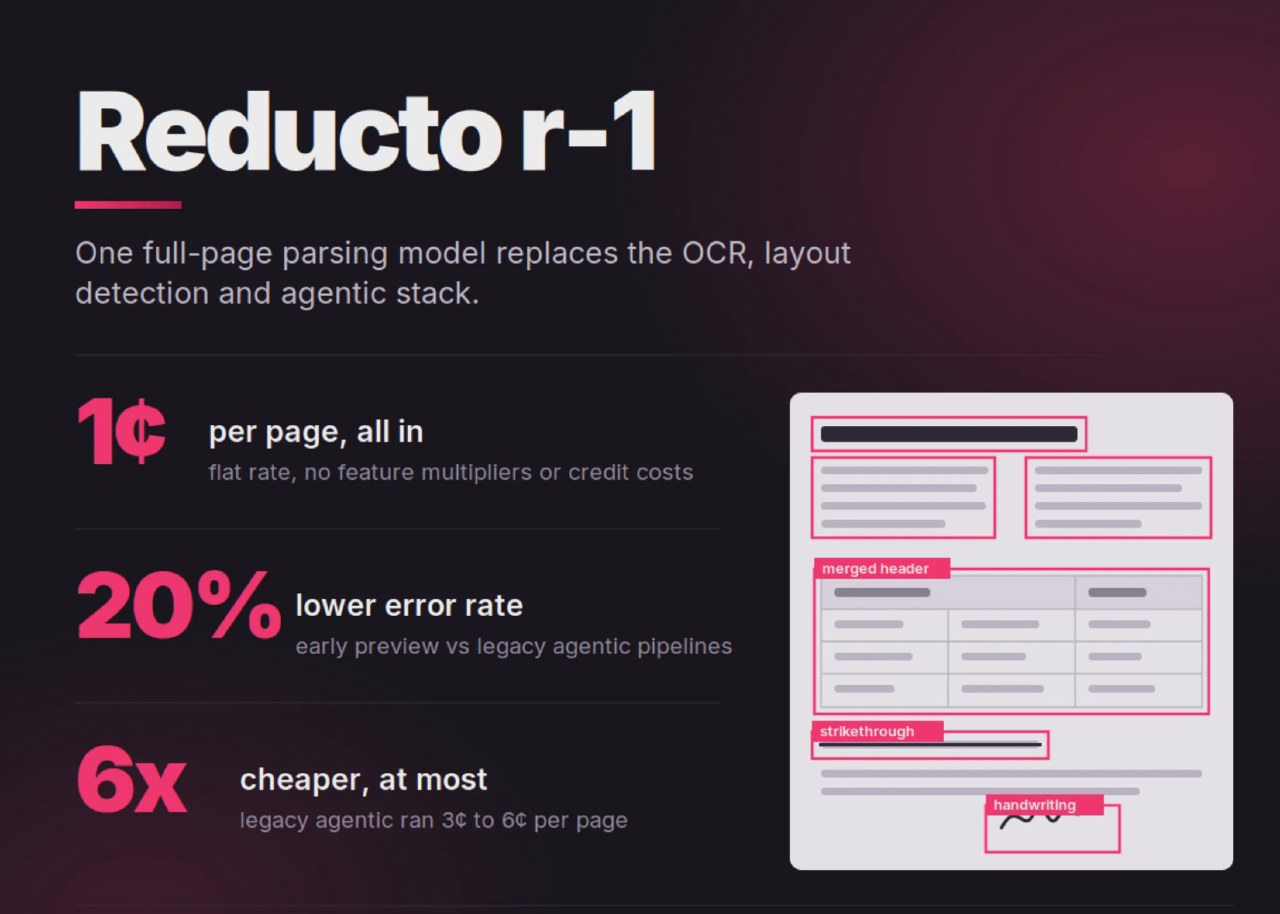
Reducto представила модель r-1 для парсинга документов, которая объединяет распознавание текста, таблиц, рисунков и разметки в один проход. Модель доступна в режиме превью через hosted Parse API на V3, активируется конфигурационным флагом. Открытых весов и локальных чекпоинтов для самостоятельного хостинга нет.
Компания сообщает о снижении уровня ошибок на 20% по сравнению с собиственными legacy-конвейерами. Согласно внутренним тестам, r-1 показала лучшие результаты, чем Amazon Textract и Azure Document Intelligence при работе со сложными документами. Модель нативно поддерживают цифровой текст, сканы, рукописный ввод, а также сложные таблицы с объединенными ячейками и вложенными заголовками.
Стоимость обработки страницы сократилась до $1 цента за страницу, тогда как legacy-модели стоили от $3 до 6 центов. Этот переход связан с общей стратегией компании по внедрению плоских тарифных планов. Для организаций, переходящих с других парсеров, Reducto предлагает до $5 000 в виде кредитов для проведения сравнительного анализа.
В планах компании выпуск r-1 mini для задач, чувствительных к скорости и стоимости, а также автоматическая маршрутизация страниц для выбора подходящей модели. Для рабочих процессов, требующих кастомных промптов или расширенного извлечения данных из графиков, Reducto сохраняет поддержку agentic-обработки, которая дополняет результаты r-1, но увеличивает задержку.



