Исследование посвящено посттренировочному квантованию семейства моделей RWKV-7 с количеством параметров от 0.1B до 13.3B. Автор применил два пресета: REDUCTION со сжатием 2.1x и COMPRESSION с 4-битным квантованием проекций и сжатием 3.1x.
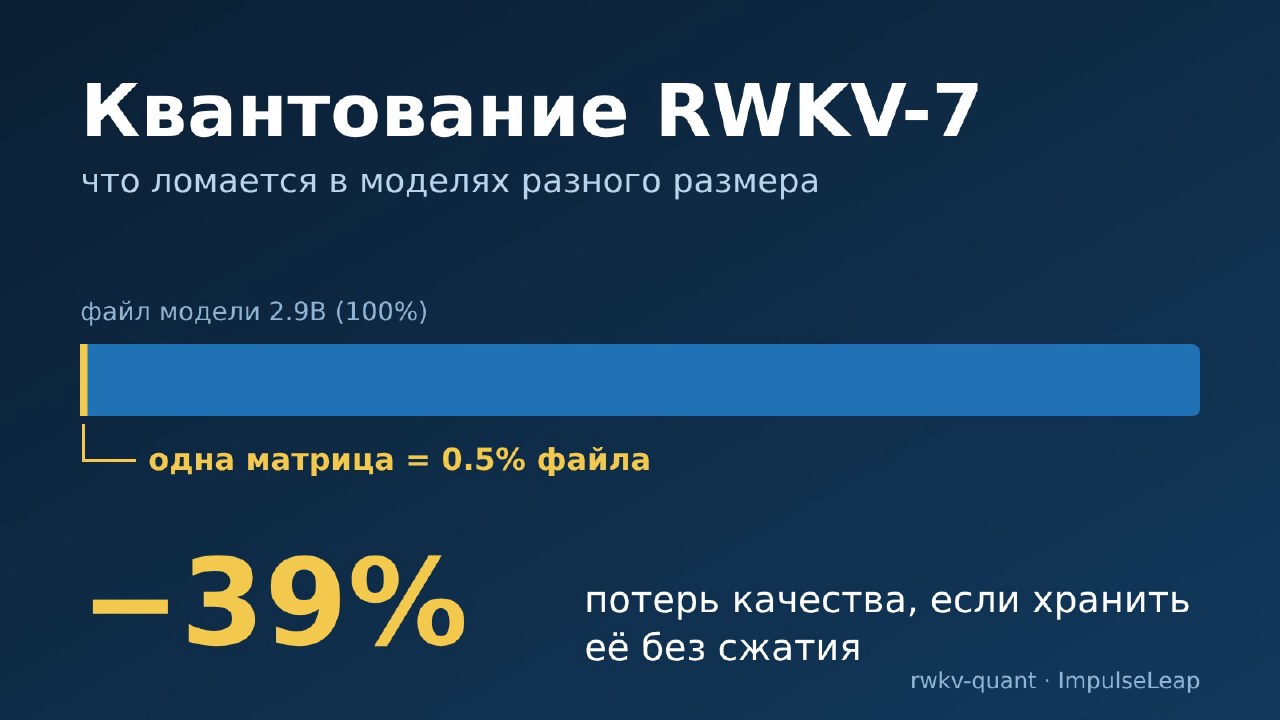
Выяснилось, что модель 2.9B деградирует сильнее, чем 1.5B, из-за критической роли одной матрицы в нулевом блоке. Хранение этой матрицы в формате bf16, что занимает 0.5% от размера файла, снижает KL-дивергенцию на 39%. Увеличение битности эмбеддинга с 5 до 6 бит дает еще 22% улучшения.
На основе анализа ошибки в остаточном потоке предложен метод автоподбора битности. В сочетании с алгоритмом GPTQ это позволило добиться потери перплексии от 0.70% до 2.76% при размере файлов 31.6–35.2% от исходного bf16. Пресет REDUCTION с GPTQ показывает потери 0.07–0.46%.
При сопоставимом размере файлов 6-битные модели с GPTQ в 2.0–3.3 раза точнее GGUF Q6_K и в 3.5–7.4 раза точнее MLX int6. 4-битный файл оказался в 2.1 раза точнее Q4_K_M на модели 1.5B. Также зафиксирован разброс GPTQ между реализациями около 1.5% по KL.