

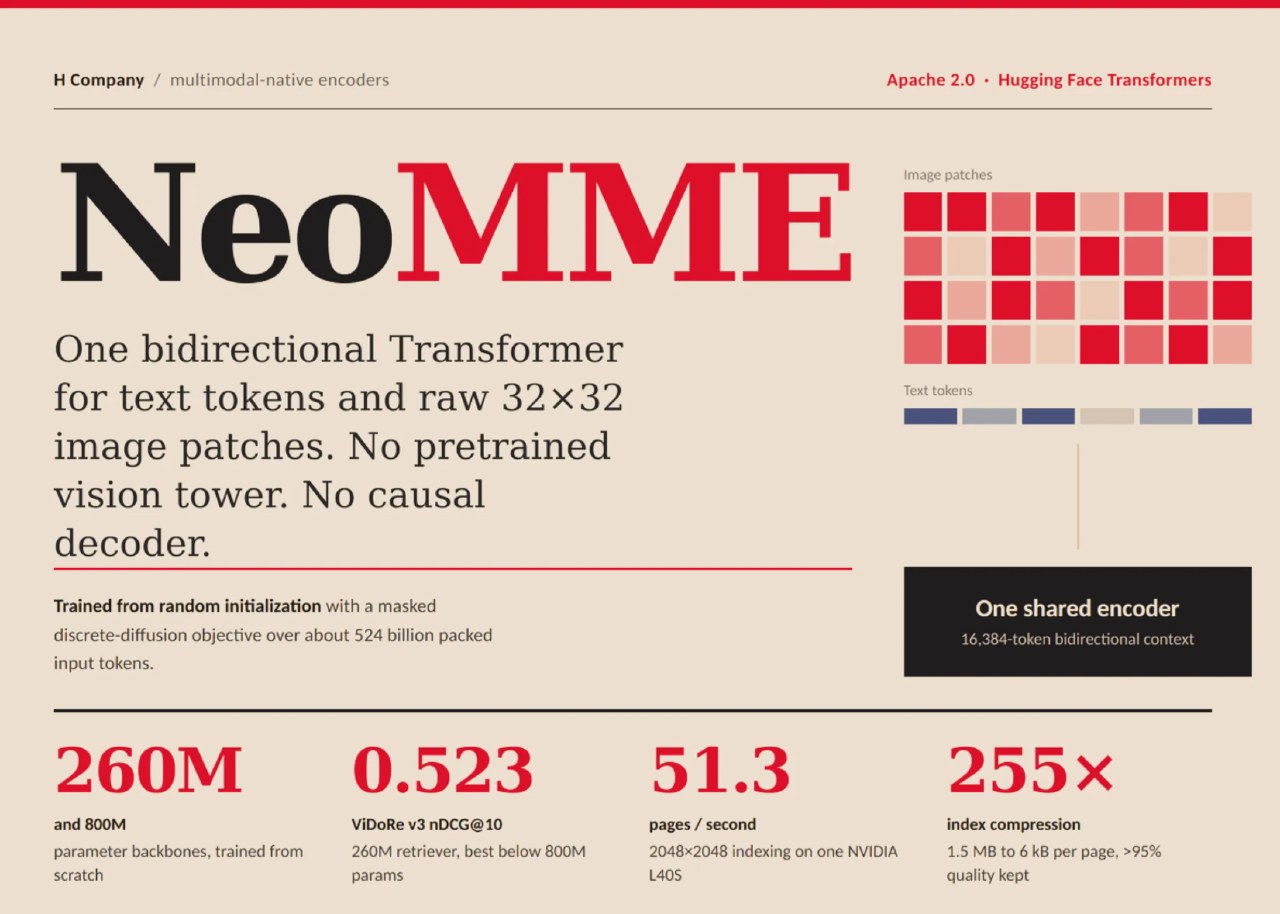
H Company представила NeoMME — семейство двунаправленных энкодеров с моделями на 260 млн и 800 млн параметров. В отличие от традиционных мультимодальных систем, NeoMME отказывается от использования отдельного визуального модуля (vision tower) и каузального декодера, используя один трансформер для обработки многоязычного текста и сырых RGB-патчей изображений размером 32x32 через одни и те же слои.
Модель на 260 млн параметров демонстрирует высокую эффективность: она индексирует 51,3 страницы в секунду на одной видеокарте NVIDIA L40S и кодирует запрос в течение 78,3 мс на хосте без GPU. Контекстное окно составляет 16 384 токена, что достаточно для двух стандартных 4K UHD изображений. Токенизатор, обученный с нуля, имеет словарь из 131 072 записей и генерирует на 44,4% меньше токенов, чем ModernBERT, для 14 целевых языков.
Предобучение проводилось методом дискретного маскированного диффузионного процесса над текстом с опциональной привязкой к патчам изображений. Модель на 260 млн параметров обучалась на 16 ускорителях H100, а версия на 800 млн — на 32 ускорителях H100, обработав по 524 млрд упакованных входных токенов. Архитектура включает в себя grouped-query attention, 2D-ротационные позиционные эмбеддинги и squared-ReLU MLP.
Версия NeoMME-Retriever показывает результаты 0,523 nDCG@10 на ViDoRe v3 для модели 260M и 0,556 для 800M. Показатель модели 260M находится в пределах 0,002 от результата ColQwen2.5-v0.2 с 3,75 млрд параметров. Для уменьшения размера индексов разработчики внедрили иерархический пулинг токенов, который позволяет сократить объем данных с 1,5 МБ до 6,0 КБ на страницу, что в 255,5 раза меньше при сохранении 95,19% базовой производительности.



