

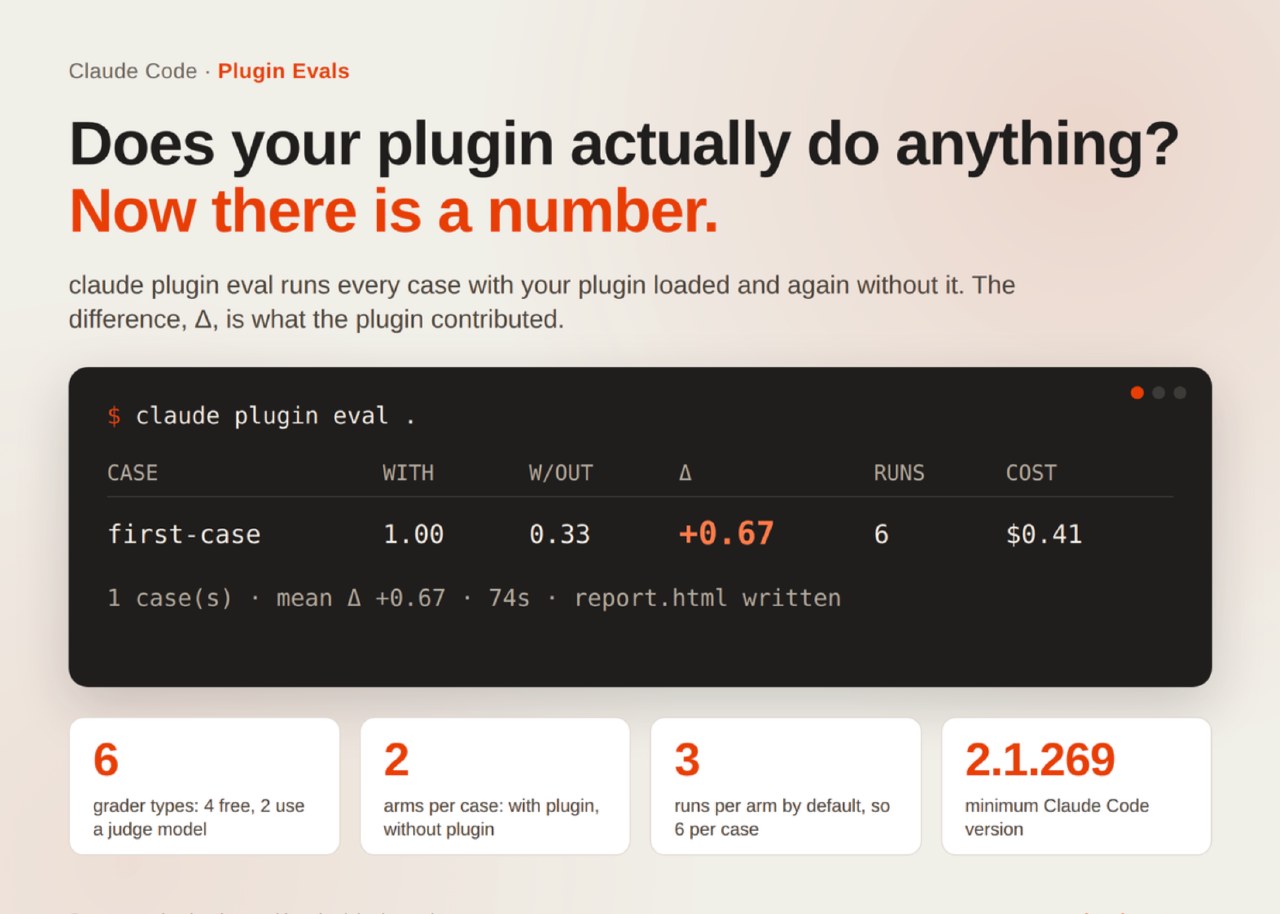
Компания Anthropic обновила Claude Code до версии 2.1.269, добавив систему оценки плагинов. Разработчики могут создавать тестовые наборы в директории evals, используя файлы подсказок и конфигурации для проверки функциональности своих инструментов.
Система включает шесть типов оценщиков: regex, tool_used, tool_order и file_exists, которые работают локально, а также llm и baseline, требующие вызова моделей. Тестирование сравнивает результаты работы с активным плагином и без него для определения его вклада.
Результаты сохраняются в HTML-отчетах с возможностью публикации на claude.ai. В CI-пайплайнах можно задавать пороговые значения баллов и лимиты затрат, например, до $20 за сессию. Все вызовы моделей оплачиваются согласно тарифному плану пользователя.
Новый функционал позволяет выявлять поведенческие ошибки, которые невозможно обнаружить при обычной проверке синтаксиса манифеста. Система помогает отслеживать, выбирает ли модель нужный навык при естественной формулировке запроса.



